傳輸量
數值越高越好0.00M objects / hr
+15K 對比 負載平衡器
MetaDefender™ 叢集1,928,000
負載平衡器1,913,000
進一步了解班尼·查尼(Benny Czarny)的著作《顛覆性的網路安全》
MetaDefender™ Cluster 會將掃描任務分散至多個 MetaDefender™Core 執行個體,在檔案量龐大的工作負載下維持高吞吐量;而僅靠負載平衡器(其僅將傳入的請求均勻分配至各伺服器,卻未考量掃描複雜度)則難以應付此類情境。
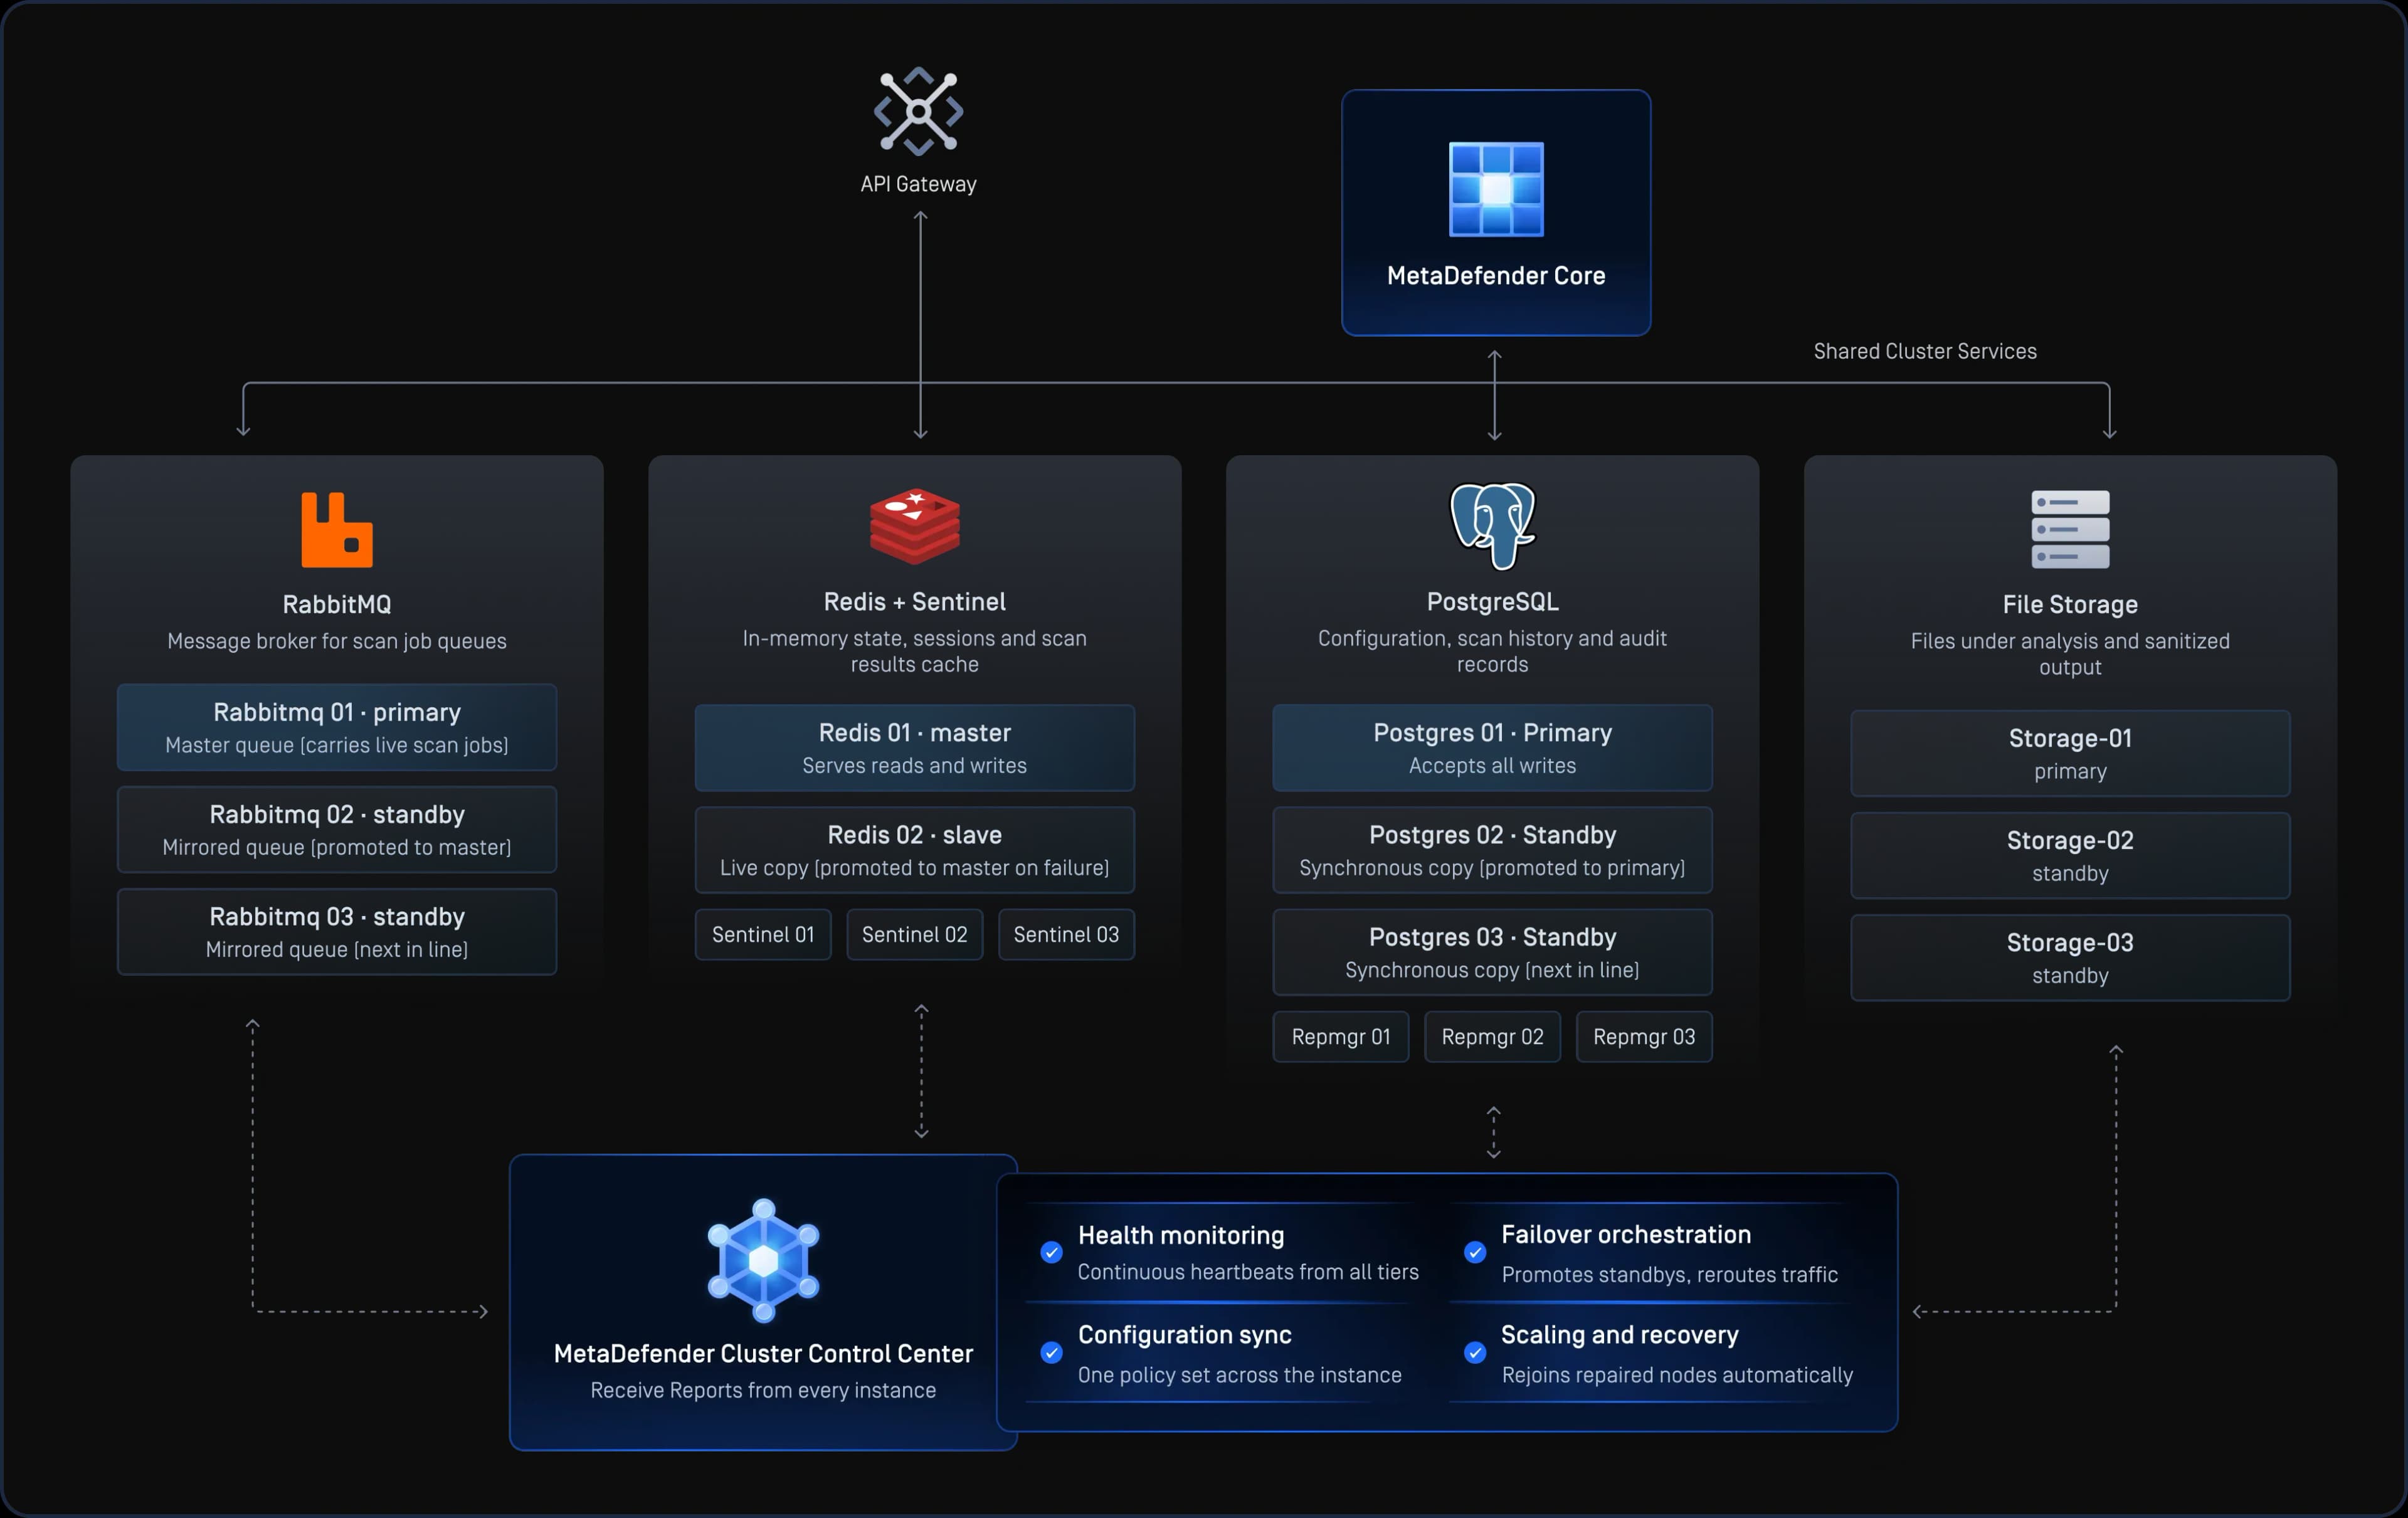
MetaDefender Cluster 專為需維持高速與高可用性的、大量且以歸檔為主的檔案處理而設計。它能智慧地將工作負載分散至MetaDefender Core 上的各實例,因此吞吐量可隨需求擴展,且即使發生單一故障,掃描作業也不會中斷。
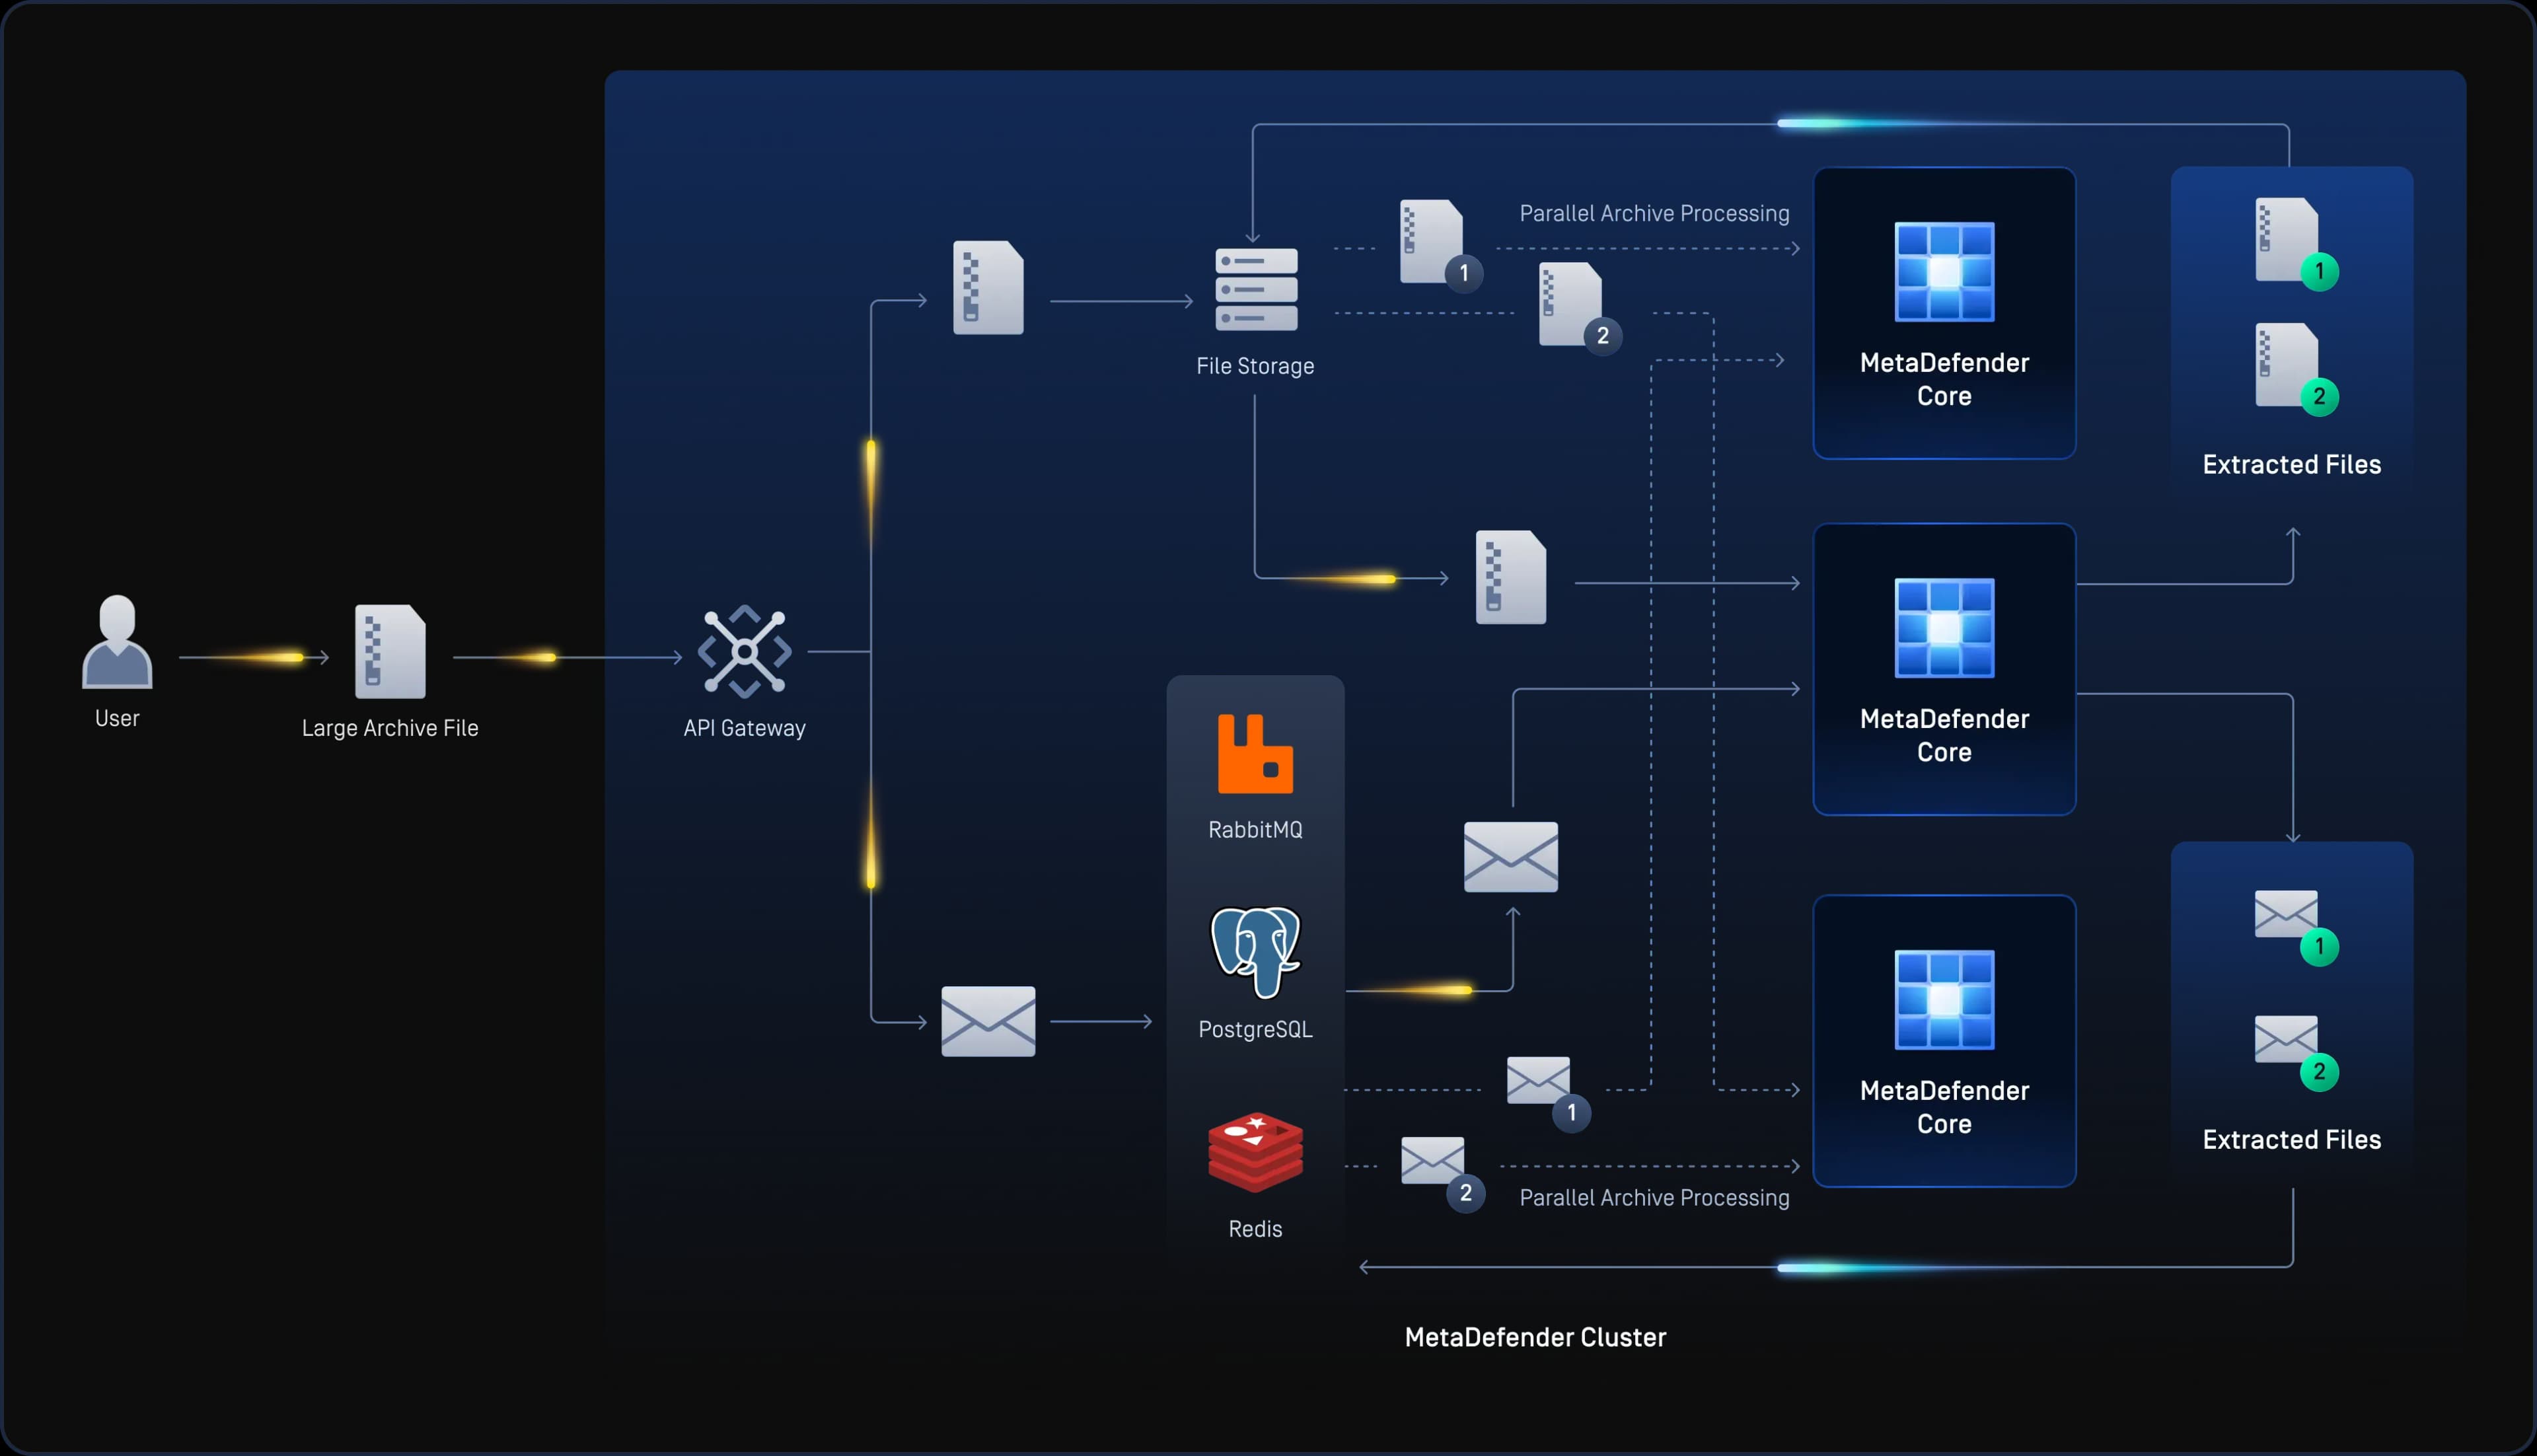
將存檔拆分,並分發至多個MetaDefender Core 實例,以便對大型深度檔案進行並行解壓縮與掃描,而非逐個處理。
新增MetaDefender Core 實例,以按需擴充容量,確保在檔案數量與歸檔大小不斷增加的情況下,處理速率仍能保持穩定。
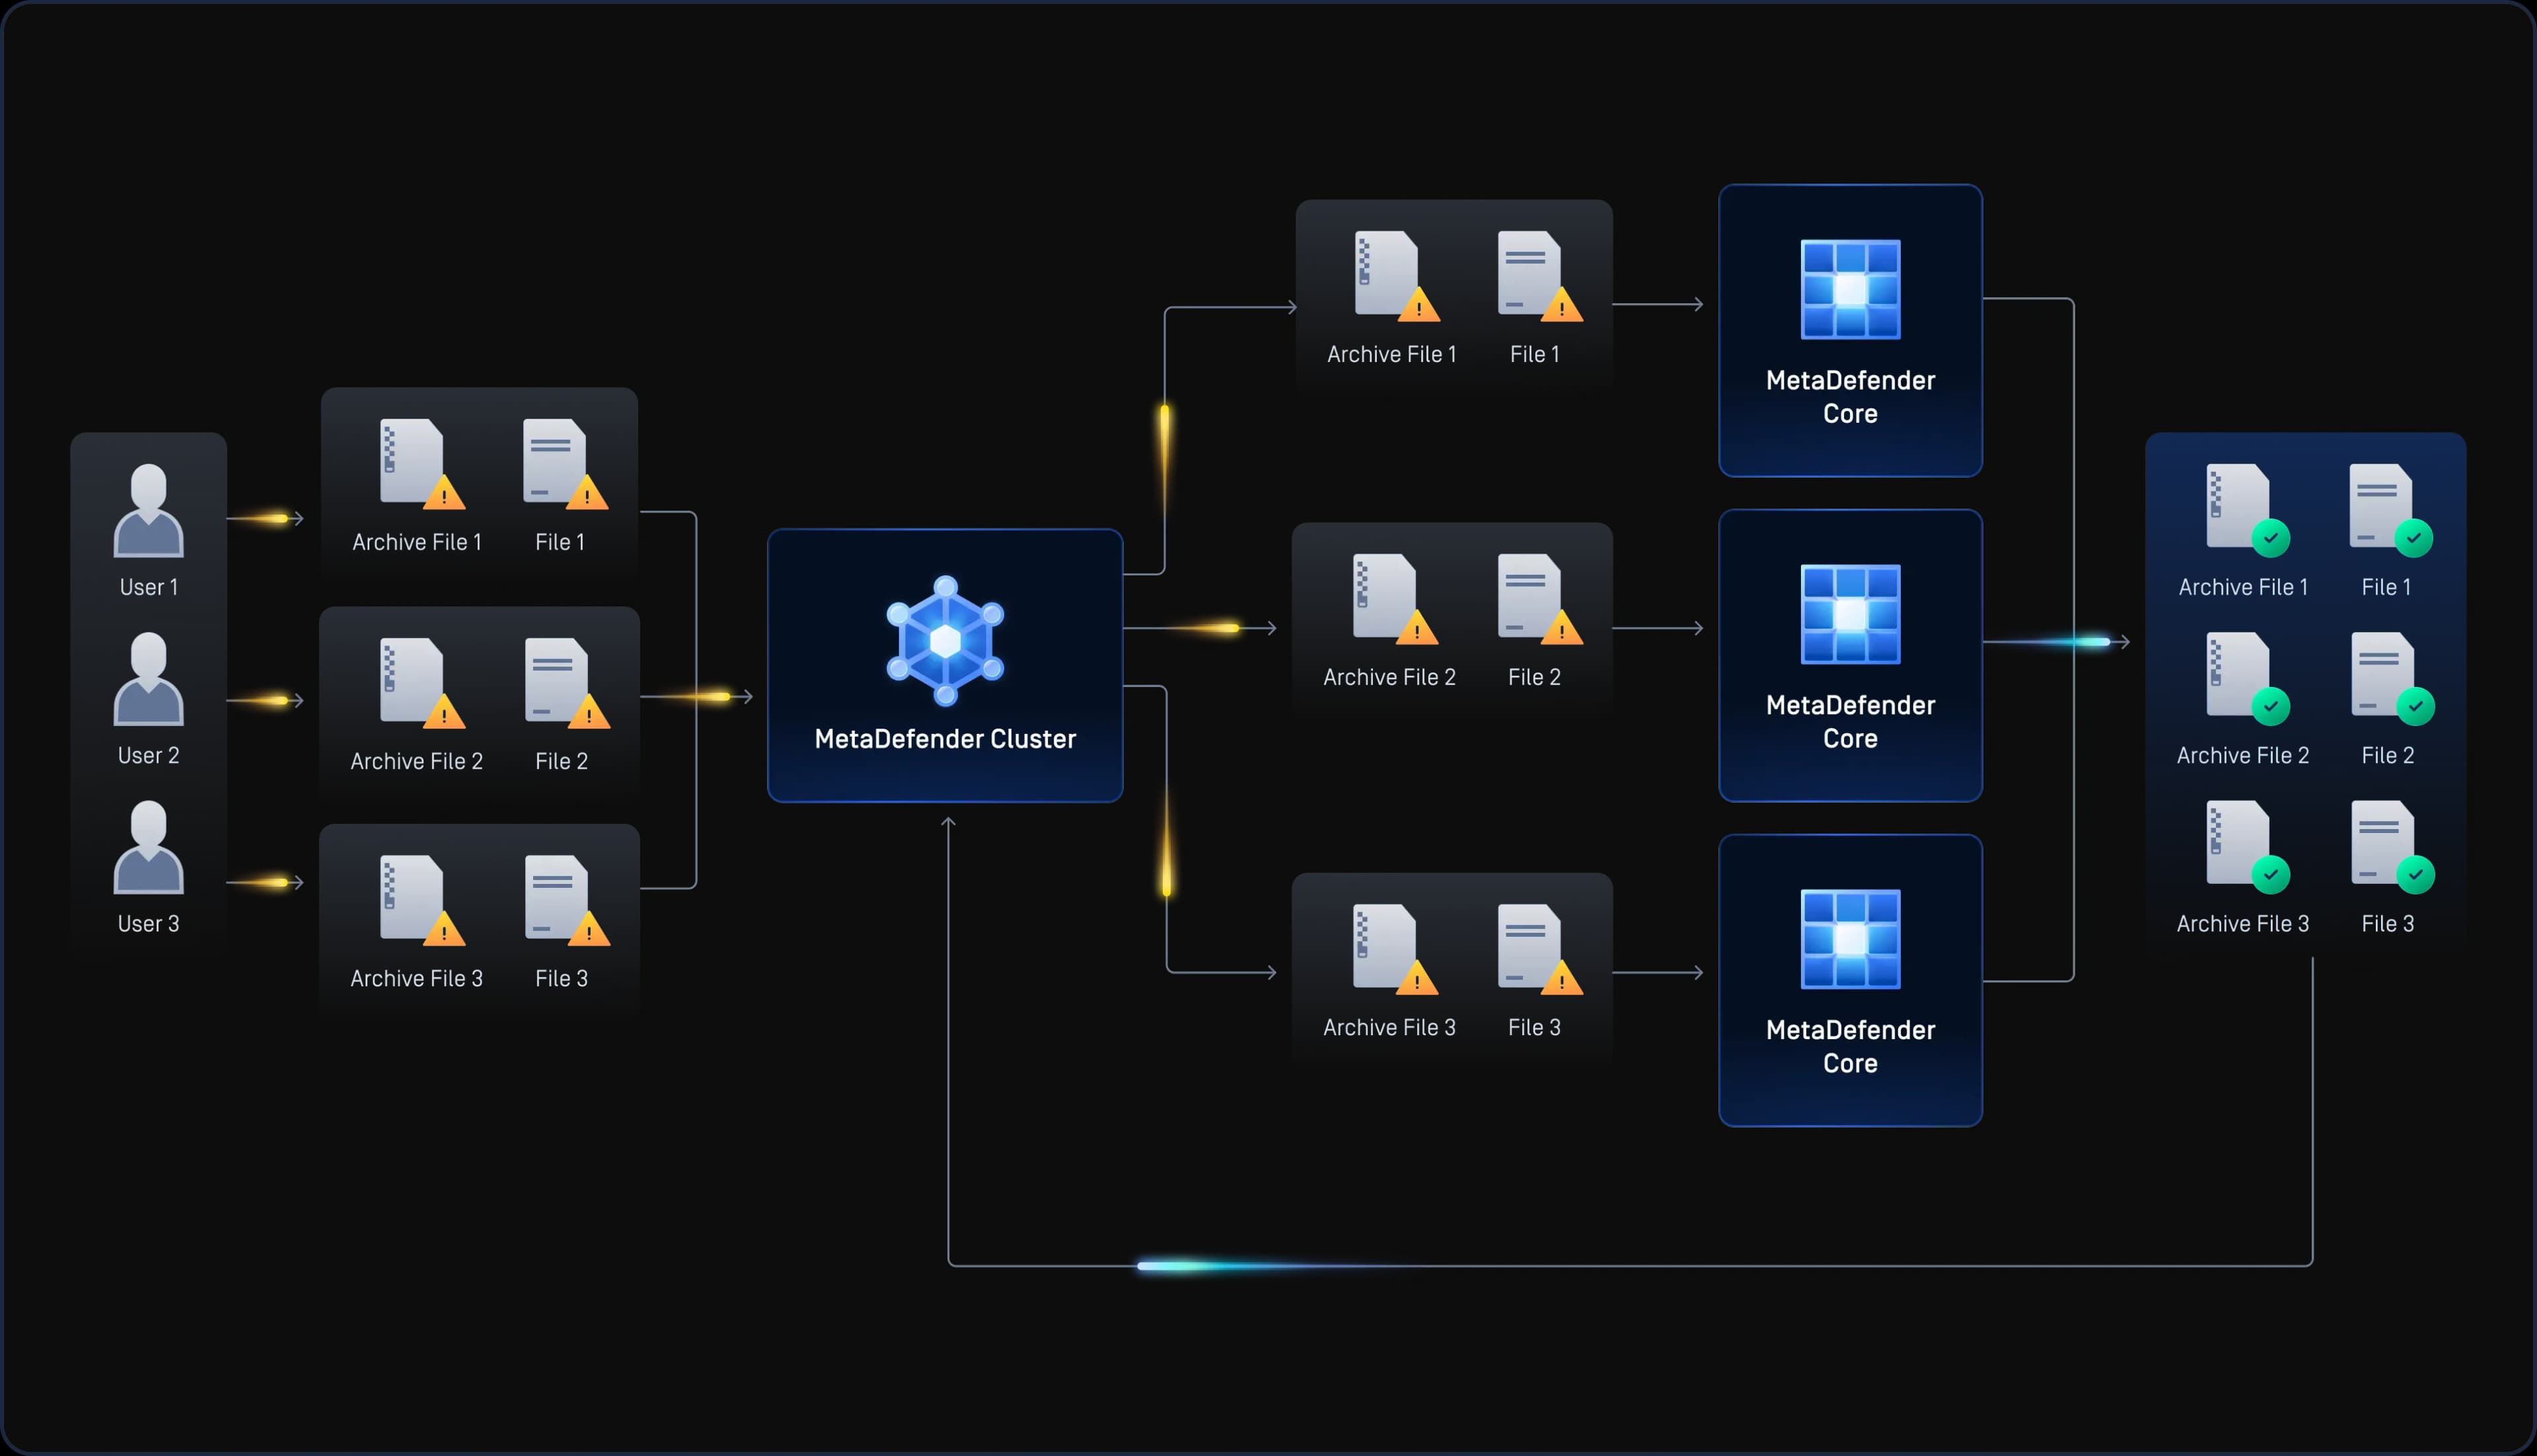
將傳入的檔案均衡分配至所有運作正常的MetaDefender Core 執行個體,確保每個引擎都能持續運作,且工作絕不會因閒置的執行個體而積壓。
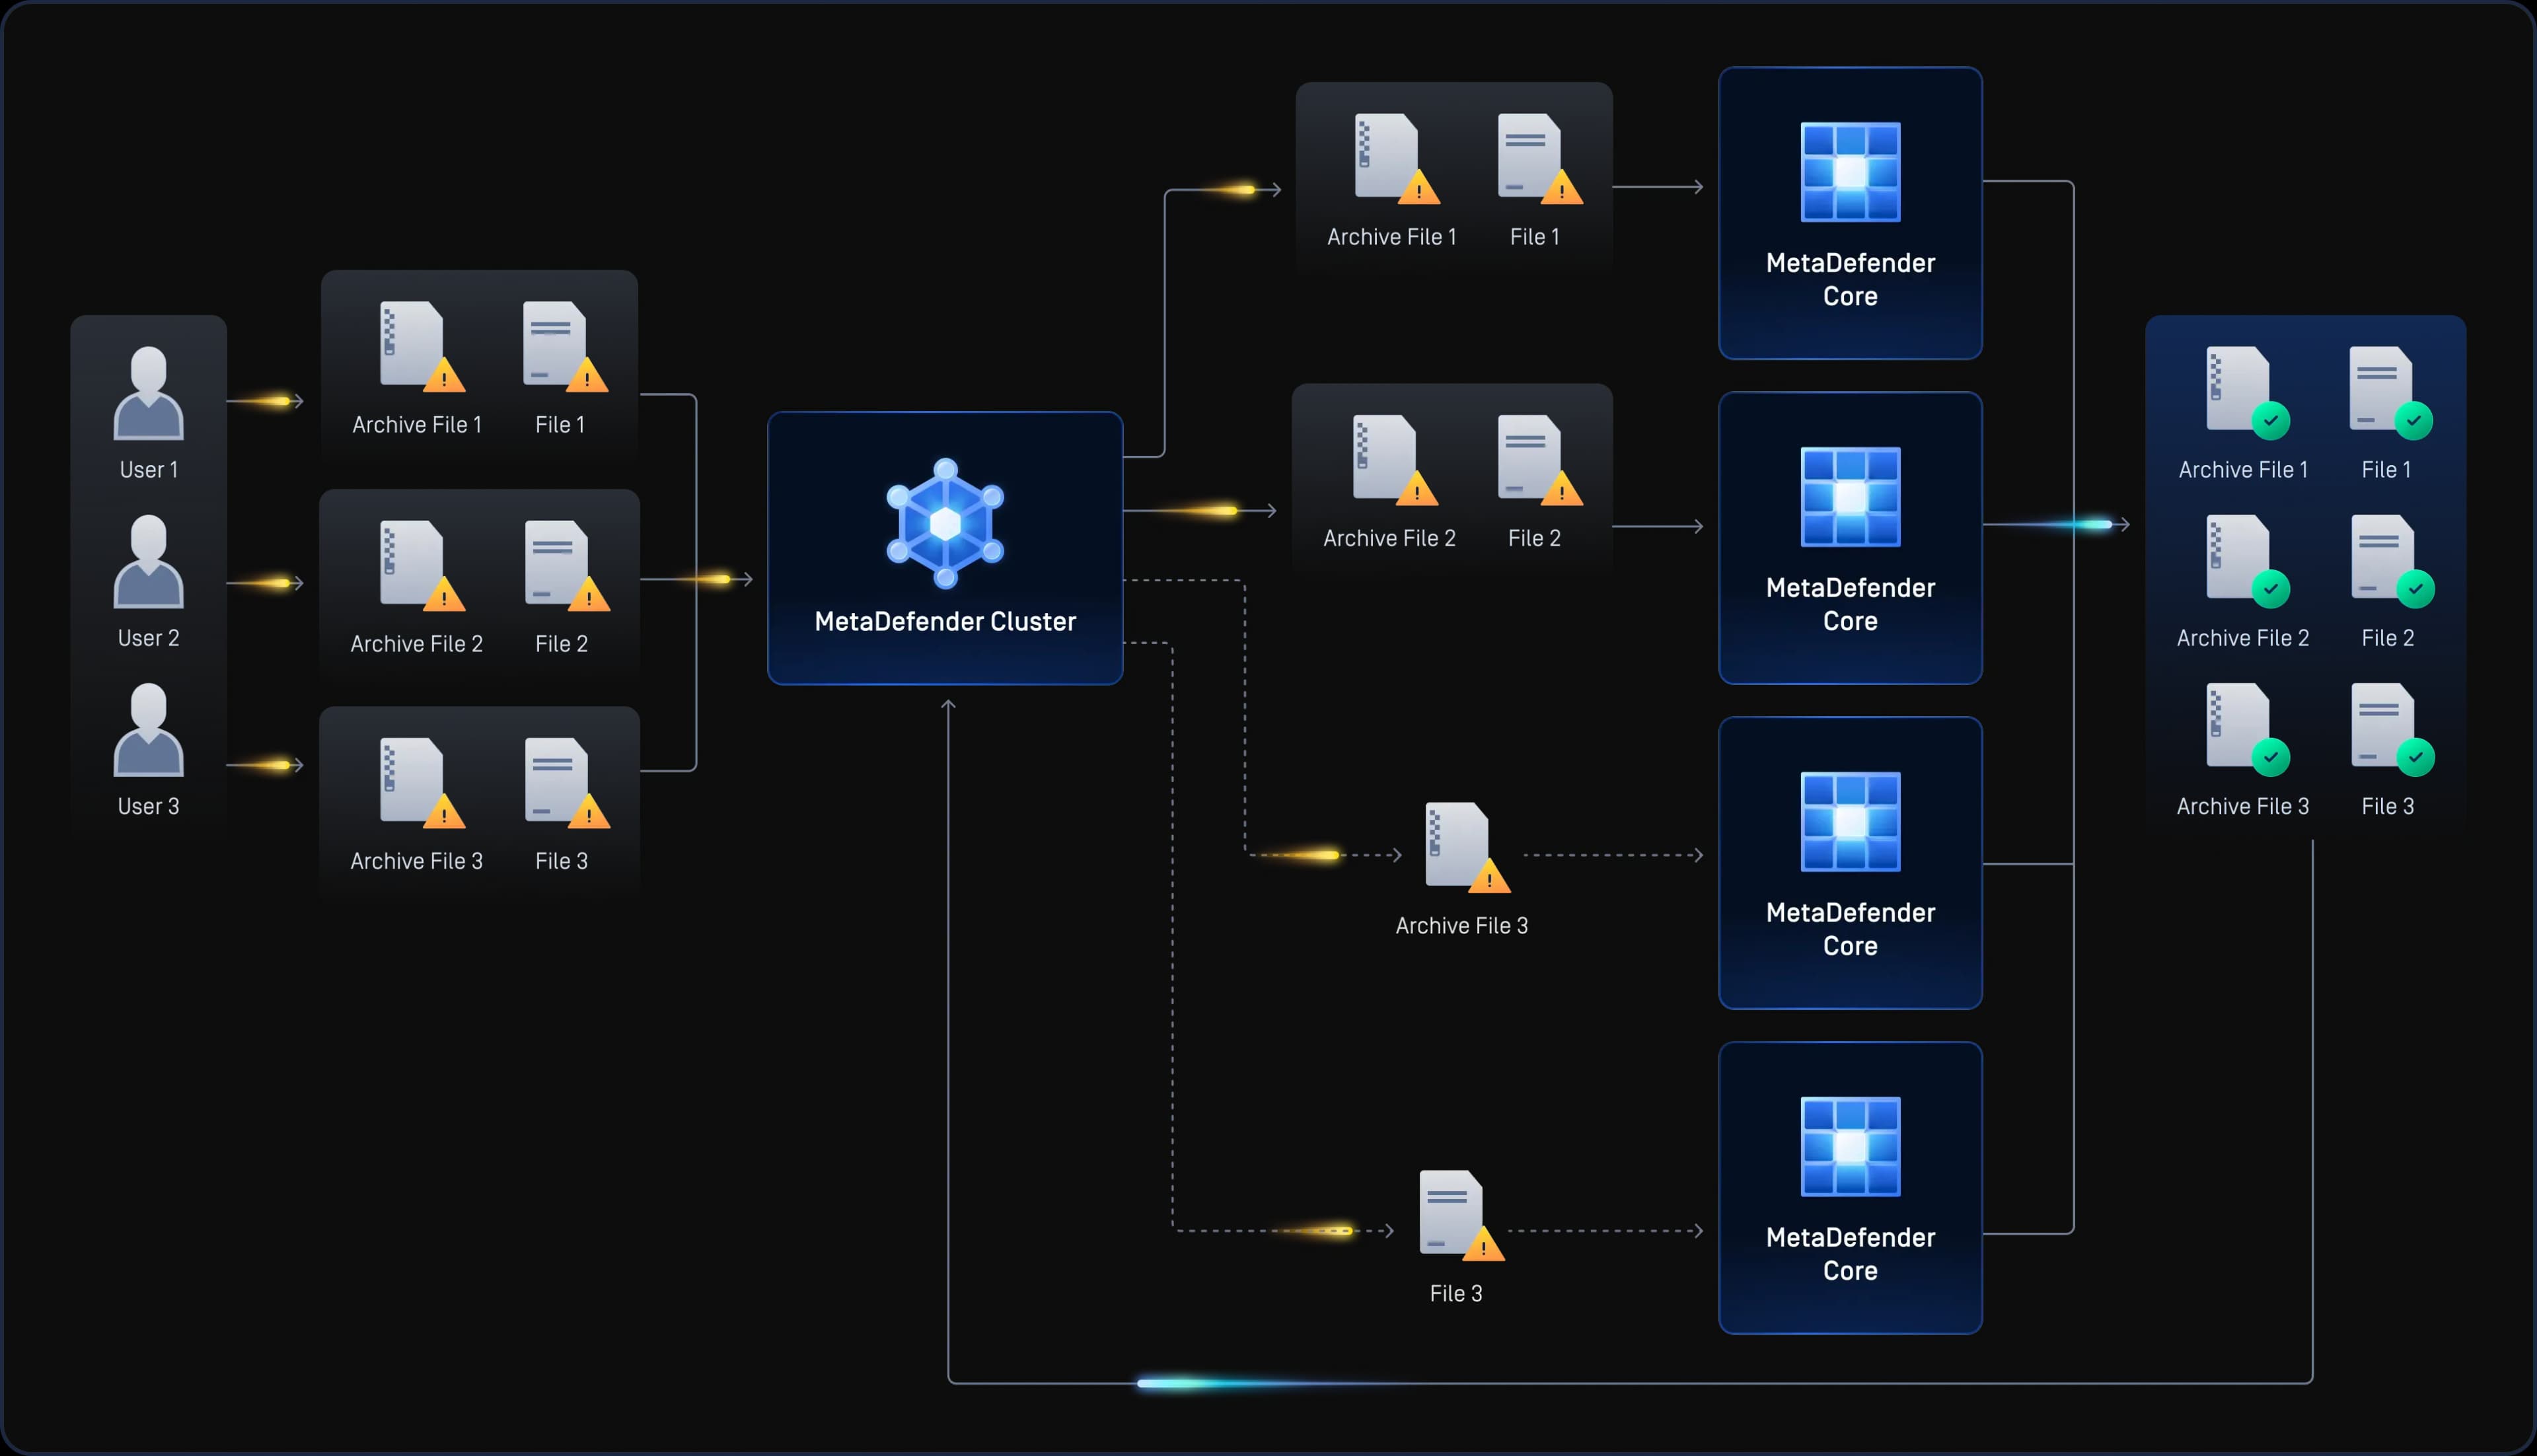
重新路由機制會繞過任何離線的MetaDefender Core 實例,因此單一故障僅會降低處理能力,而非中斷掃描作業。
將存檔拆分,並分發至多個MetaDefender Core 實例,以便對大型深度檔案進行並行解壓縮與掃描,而非逐個處理。
新增MetaDefender Core 實例,以按需擴充容量,確保在檔案數量與歸檔大小不斷增加的情況下,處理速率仍能保持穩定。
將傳入的檔案均衡分配至所有運作正常的MetaDefender Core 執行個體,確保每個引擎都能持續運作,且工作絕不會因閒置的執行個體而積壓。
重新路由機制會繞過任何離線的MetaDefender Core 實例,因此單一故障僅會降低處理能力,而非中斷掃描作業。
這些數據源自涵蓋從單一文件到大型嵌套檔案庫等各類工作負載的基準測試,顯示MetaDefender Cluster 如何維持吞吐量、隨著您新增MetaDefender Core 執行個體而擴展,並確保每個引擎皆能保持高利用率運作。
比負載平衡器更……
涵蓋所有MetaDefender Core 實例
比負載平衡器更……
MetaDefender Cluster 將多個MetaDefender Core 實例整合為一個彈性掃描池,因此隨著您增加容量,吞吐量與韌性將同步提升。
能讓每個處理核心持續運作,因此即使在突發性且以歸檔為主的流量環境下,當負載平衡器導致處理能力閒置時,處理速率仍能維持穩定。
將單一大型存檔中的嵌套內容分散至多個MetaDefender Core 實例,而非將其固定在單一實例上,這正是實現最大速度提升的關鍵。
新增MetaDefender Core 實例以擴增運算能力。吞吐量將隨之提升,處理時間則會縮短,且您可據此進行規模規劃與預算編列。
重新路由機制能繞過任何離線的MetaDefender Core 實例,因此單一故障僅會降低處理能力,而非 中斷掃描作業。
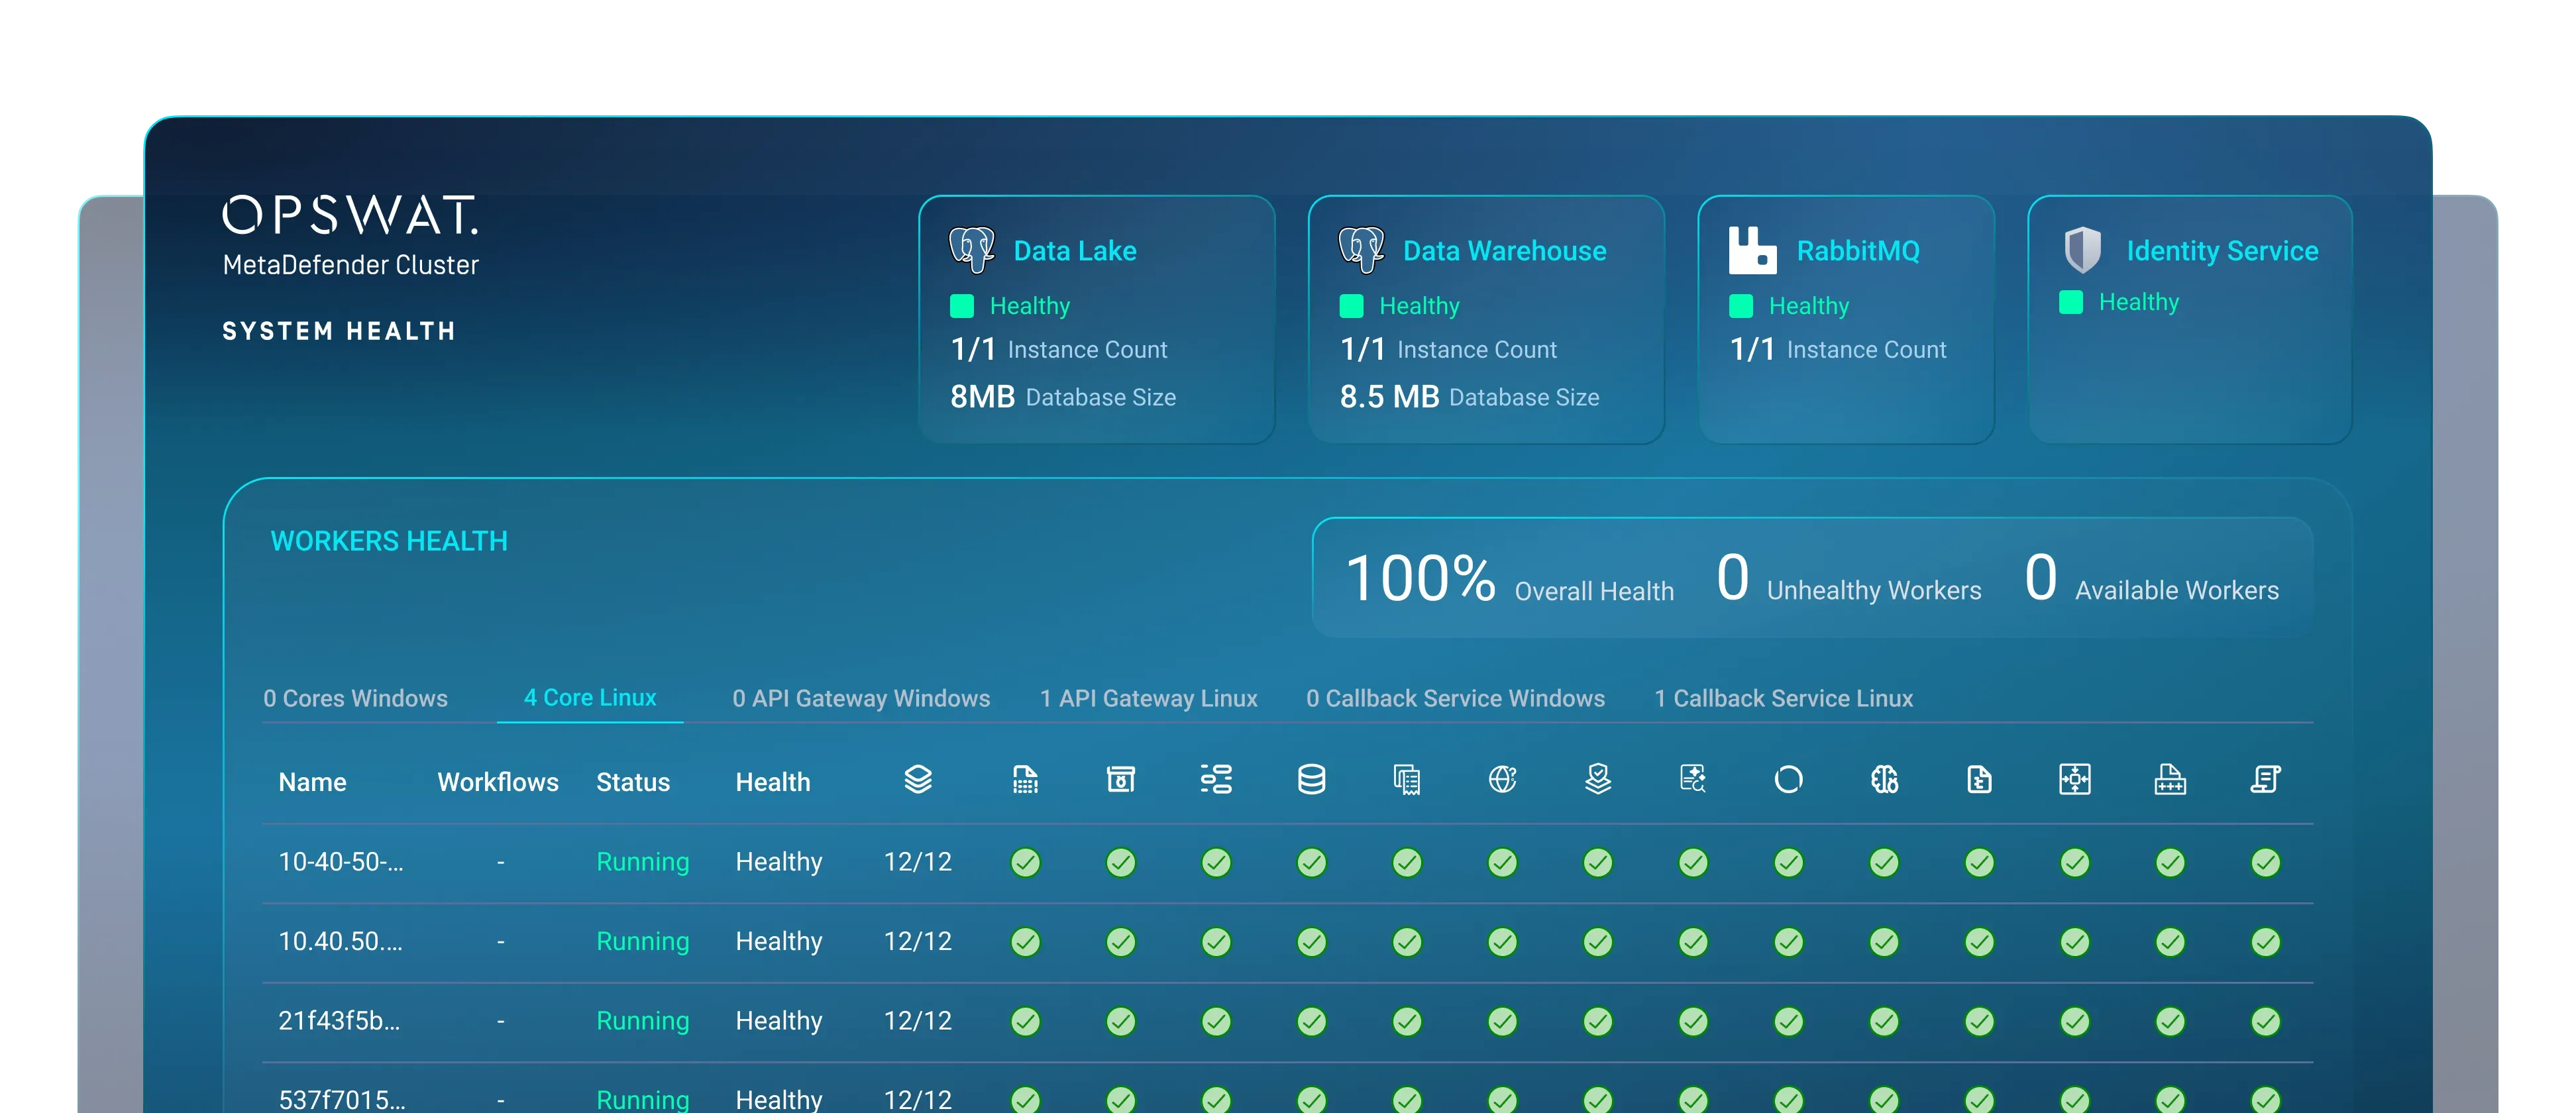
透過單一控制台即可設定工作流程、監控引擎運作狀態,並檢視整個叢集的結果,無需手動管理每個節點。
了解MetaDefender 叢集部署與負載平衡器的差異。我們針對三組資料集(範圍從單一文件到大型嵌套檔案庫)分別在兩種設定下進行測試,以測量吞吐量、執行時間及資源使用情況。如欲進一步了解測試環境的設定,請參閱MetaDefender 叢集文件。
Aggressively submitted 2,000,000 non-archive files at a rate of 800 files per second. With no archives to distribute, both deployments perform nearly the same.
Submitted 400 medium archive files (RPM, CAB, EXE) at a rate of 1 file per second. Distributing nested files lets MetaDefender™ Cluster pull clearly ahead.
Submitted large CAB files (5.1 GB compressed, 217 GB extracted) with load sharing enabled. This is where archive distribution matters most.
將相同的数据集透過MetaDefender 叢集進行處理,以觀察當您增加MetaDefender Core 執行個體的數量時,吞吐量如何提升,而處理時間如何縮短。
以每秒 800 個檔案的速度提交了 2,000,000 個檔案。增加處理核心數可將吞吐量提升近三倍,並將執行時間縮短至約三分之一。
12 MetaDefender Core | 4 MetaDefender Core | |
|---|---|---|
每小時處理的物件數 | 2,850,000 | 1,000,000 |
總時長 | 42 分鐘 | 120 分鐘 |
以每秒 1 檔的速度提交 400 檔檔案。嵌套檔案會分散到更多處理核心上,因此吞吐量差距急遽擴大。
12 MetaDefender Core | 4 MetaDefender Core | |
|---|---|---|
每小時處理的物件數 | 4,900,000 | 1,050,000 |
總時長 | 30 分鐘 | 115 分鐘 |
4 個已啟用歸檔負載平衡的檔案。將單一大型歸檔檔案分散至MetaDefender Core 上的多個實例,正是MetaDefender 叢集所設計的用途。
12 MetaDefender Core | 4 MetaDefender Core | |
|---|---|---|
每小時處理的物件數 | 4,000,000 | 1,200,000 |
總時長 | 52 分鐘 | 180 分鐘 |
在大型歸檔工作負載下,速度約快 2 倍。 在基準測試中,MetaDefender 叢集以每小時 2,120,000 個物件的速度,於 175 分鐘內處理完一個大型 CAB 資料集;相較之下,負載平衡部署的處理速度為每小時 1,050,000 個物件,耗時 353 分鐘——處理時間約為其一半。此優勢源自於歸檔內容的分散處理,因此在非歸檔檔案方面,兩者的表現幾乎相同。
存檔負載平衡會將單一存檔中的嵌套內容分散至多個MetaDefender Core™ 執行個體,因此一個大型存檔會以並行方式進行解壓縮與掃描,而非被固定在單一執行個體上。這是迄今測量到的最大速度提升背後的核心機制——負載平衡器會將每個檔案完整地路由至一個執行個體,同時讓執行個體池中的其餘執行個體保持閒置狀態。
吞吐量隨之上升,而處理時間則近乎呈線性下降。在針對非歸檔資料集進行的基準測試中,將MetaDefender Core 的執行個體數量從 4 個擴展至 12 個後,每小時的吞吐量從 1,000,000 個物件提升至 2,850,000 個物件,執行時間則從 120 分鐘縮短至 42 分鐘——也就是在約三分之一的時間內,吞吐量提升了約 2.9 倍。對於以歸檔為主的工作負載,效益更為顯著。
這取決於您的檔案量、流量中歸檔檔案所佔的比例,以及您的吞吐量目標。由於歸檔內容會分散儲存於各執行個體中,因此在檔案數量相同的情況下,相較於僅包含文件的工作負載,歸檔佔比較高的工作負載能從更多執行個體中獲得更大效益。請將您的檔案量、歸檔檔案比例及吞吐量目標提供給OPSWAT ,以便根據您的工作負載規模進行負載估算。
在基準測試中,MetaDefender 叢集於負載平衡器比較情境下,每小時可處理約 190 萬至 210 萬個物件;而在擴展至 12 個MetaDefender Core 執行個體的大型歸檔工作負載情境下,每小時最高可處理 4,000,000 個物件。實際吞吐量取決於檔案組成、歸檔層級、執行個體數量以及已啟用的引擎。
差異極小。在針對 2,000,000 個非歸檔檔案進行的基準測試中,MetaDefender 叢集每小時處理 1,928,000 個物件,而負載平衡部署則為 1,913,000 個——由於無需分發歸檔內容,兩者差距不到 1%。MetaDefender 叢集的優勢主要體現在歸檔內容佔比高的工作負載,以及擴展執行個體數量時。
MetaDefender 叢集會將該執行個體的工作負載重新導向至其餘的正常運作執行個體,因此單一故障僅會減少可用容量,而非中斷掃描作業。傳入的檔案會持續在所有正常運作的MetaDefender Core 執行個體之間進行負載平衡,因此工作絕不會因某個執行個體離線或閒置而積壓。